
大厂真题 / 滴滴
滴滴 2026-9-6 笔试真题 - 后端研发岗
公式说明:数学公式保留为原始矢量图,避免抓取转换造成变量和约束缺失。
滴滴2026-9-6笔试真题 - 后端研发岗
题解整理了这场考试的完整题解和代码,希望能帮助大家更好地准备后续笔试。
本场考试概述
考试时间 :2026-9-6 考试岗位 :后端研发 难度评级 :中等偏难 考点分析 :
-
- 选择题:操作系统、计算机网络、数据库、图论、查找、分治、Java 基础,以基础知识为主,难度从入门到中等
-
- 第一题:排序 + 双指针计数(难度困难)
-
- 第二题:前缀和 + 枚举中间切点 + 双指针(难度中等)
建议策略 :
-
- 选择题这部分主要吃八股积累,操作系统占比最高,进程与线程、静态路由配置、文件权限这类题基本是背过就能拿分,考前过一遍高频点性价比很高。
-
- 两道编程题的共同点是”暴力枚举必然超时,要先找到一个能把枚举量降下来的切入角度”。第一题是选对插入顺序,第二题是先固定中间那一刀,都属于想通了代码就很短的类型,卡住时优先想怎么换个顺序枚举,而不是急着优化常数。
-
- 第一题的取模计数容易在相同身高上翻车,务必把学号不同当作不同方案;第二题的平衡点要把指针停下的那一格和它左边一格都试一遍,只取一侧会漏解。这两处是本场编程题最主要的丢分点。
选择题(12道)
1、在 IPv6 过渡技术中,允许 IPv6 数据包穿越 IPv4 网络的技术是()。 A. 双协议栈 B. 手动配置 C. NAT-PT D. 隧道技术 答案 :D 难度 :入门 考点 :计算机网络 解释 :隧道技术把整个 IPv6 报文当作载荷封装进 IPv4 报文头里,中间的纯 IPv4 网络只看外层 IPv4 头正常转发,到达隧道出口再拆封还原成 IPv6 包,这正是”穿越 IPv4 网络”的定义,故选 D。A 双协议栈是让同一台设备同时跑 IPv6 和 IPv4 两套协议栈,解决的是”设备能不能同时说两种话”,并不能让 IPv6 报文通过只认 IPv4 的中间网络。B 手动配置只是隧道端点地址的一种配置方式,属于隧道技术的子项而非并列的技术名称。C NAT-PT 做的是 IPv6 地址与 IPv4 地址之间的协议转换,让 IPv6 主机去访问 IPv4 主机,报文在转换后就不再是 IPv6 包了,属于”翻译”而非”穿越”。 2、关于 BFS 和 DFS 说法正确的是() A. 使用 DFS 查找最短路径 B. 使用 BFS 查找最短路径 C. BFS 占内存少但速度较快 D. DFS 占内存少但速度较慢 答案 :B, D 难度 :简单 考点 :图论 解释 :
- • A 错误:DFS 沿着一条路走到底才回溯,先找到的路径未必最短,要拿它求最短路必须枚举全部路径再取最小,代价高且不是它的本职工作。
- • B 正确:在边权全为
 的图上 BFS 按层扩展,第一次访问到某个结点时经过的边数一定最少,天然给出最短路径。
- • C 错误:BFS 要把整层结点全压进队列,队列规模取决于图的最大宽度,在稠密图或高分支因子的图上是指数级的,内存开销恰恰比 DFS 大。
- • D 正确:DFS 只需保存当前这一条路径上的结点,栈深等于路径长度即树高,空间是
 远小于 BFS;代价是找目标时可能先钻进很深的错误分支,在求最短路这类场景下比 BFS 慢。
3、要将天、地、玄、黄存放在顺序表中,查找天、地、玄、黄的概率依次是 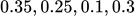 ,为提高顺序查找效率,合理的存放顺序是
A. 玄天地黄
B. 天地玄黄
C. 天黄地玄
D. 黄玄地天
答案 :C
难度 :简单
考点 :查找
解释 :顺序查找从表头逐个比较,元素放在第
 位时查找它需要比较
 次,平均查找长度为
 。这是一个加权和,要让它最小就必须让权重(概率)大的元素配上小的下标,即按概率从大到小排列 。四者概率排序为天
 黄
 地
 玄
 ,故顺序应为天、黄、地、玄,选 C,此时平均查找长度为
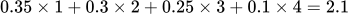 。B 是按原始字面顺序排的,平均查找长度为
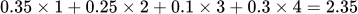 ,A 和 D 更差,D 恰好是概率升序、结果最劣。
4、以下哪些是分治法在实际应用中可能面临的挑战?
A. 递归调用导致栈溢出风险
B. 难以并行化处理
C. 对输入数据顺序敏感
D. 子问题合并代价过高
答案 :A, C, D
难度 :中等
考点 :分治
解释 :
- • A 正确:分治靠递归实现,递归深度在最坏情况下可达
 (如快速排序每次只划分出一个元素),每层都要压栈帧,深度大时会撑爆系统栈。
- • B 错误:说反了。分治切出的子问题互不重叠、彼此独立,正是最容易并行化 的算法范式之一,各子问题可以直接分发到不同线程或机器上同时算,这是分治的优点而非挑战。
- • C 正确:分治的性能依赖划分是否均衡,而划分好坏往往由输入顺序决定。快速排序在已经有序的输入上每次划分都极度倾斜,复杂度从
 退化到
 。
- • D 正确:分治的总代价是”分解 + 递归求解 + 合并”,若合并这一步代价过高,收益会被吃掉。按主定理
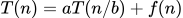 ,当
 增长过快时整体复杂度由合并项主导,分治就不划算了。
5、在 HTTP/1.1 中,下列哪个状态码表示”请求由于包含错误的语法而无法被服务器理解”()。
A. 403
B. 404
C. 400
D. 401
答案 :C
难度 :入门
考点 :计算机网络
解释 :  Bad Request 的语义就是请求报文本身有语法错误、服务器无法解析,故选 C。
 Unauthorized 表示请求缺少或携带了无效的身份认证凭据,属于”你是谁没说清”;
 Forbidden 表示服务器已经认出你是谁、但拒绝授权你访问该资源,属于”知道你是谁但不让你进”;
 Not Found 表示请求语法正确、服务器也理解了,只是目标资源不存在。四者都是 4xx 客户端错误,区别在于出错的环节:
 卡在解析阶段,
 卡在鉴权阶段,
 卡在资源定位阶段。
6、要使添加的路由规则在 CentOS/RHEL 7 系统重启后依然生效,应采用哪种配置方式()。
A. 将路由命令写入 /etc/rc.local 文件
B. 在 /etc/sysconfig/network-scripts/route- 文件中配置
C. 使用 crontab 的 @reboot 指令
D. 修改 /etc/hosts 文件
答案 :B
难度 :简单
考点 :操作系统
解释 :CentOS/RHEL 7 为持久化静态路由专门提供了
/etc/sysconfig/network-scripts/route-<网卡名> 配置文件,network 服务在启动对应网卡时会读取并自动下发这些路由,这是发行版官方推荐的标准做法,故选 B。A 在 RHEL 7 上 /etc/rc.local 默认不带可执行权限、rc-local.service 也不默认启用,且它在网络服务之后才跑,属于能绕但不规范的野路子。C @reboot 是 cron 的开机任务,同样能达到目的却把网络配置塞进了任务调度器,与网卡生命周期脱节,网卡重启(而非系统重启)时路由就丢了。D /etc/hosts 管的是主机名到 IP 的静态解析,和路由表毫无关系。
7、下列关于进程和线程的比较描述正确的是:()
A. 线程同样具有就绪、阻塞、执行三种基本状态,同样具有状态之间的转换关系
B. 线程能减少并发执行的时间和空间开销
C. 进程是资源分配的最小单位,线程是 CPU 调度的最小单位
D. 进程拥有一个完整的资源平台,而线程只独享必不可少的资源,如寄存器和栈
答案 :A, B, C, D
难度 :简单
考点 :操作系统
解释 :
- • A 正确:线程作为独立的调度单位,同样要在就绪、运行、阻塞三态之间迁移,转换条件(被调度、时间片用完、等待 I/O、等待事件完成)也与进程一致。
- • B 正确:线程创建、终止、切换都不必新建或撤销进程地址空间与页表,同进程内线程切换无需刷新 TLB 与切换页目录,时间开销远小于进程;线程共享代码段、数据段与打开的文件描述符,空间开销同样更小。
- • C 正确:这是操作系统教材的标准表述。资源(地址空间、文件句柄)按进程分配,而 CPU 时间片按线程分派,两者是不同维度的最小单位。
- • D 正确:进程持有完整的资源平台(地址空间、全局变量、打开文件、信号处理),线程在其上只私有那些各跑各的绝不能共享的部分——程序计数器、通用寄存器、栈以及线程本地存储。
8、Linux 内核启动时,bootloader 传递给内核的命令行参数可通过查看哪个 procfs 文件获取()。
A. /boot/grub/grub.cfg
B. /etc/default/grub
C. /sys/kernel/boot_params
D. /proc/cmdline
答案 :D
难度 :简单
考点 :操作系统
解释 :题干限定了”procfs 文件”,即 /proc 下的文件,四个选项中只有 D 在 /proc 里,内核把本次启动实际收到的命令行原样导出在 /proc/cmdline,cat 一下即可看到,故选 D。A /boot/grub/grub.cfg 是 GRUB 生成的引导菜单配置,属于磁盘上的普通文件,记录的是”打算传什么”而非”本次实际传了什么”,手工改过启动项后两者会不一致。B /etc/default/grub 是生成 grub.cfg 的模板源,隔得更远。C 位于 sysfs(/sys)而非 procfs,路径前缀就不符题干要求,且它暴露的是启动参数结构体而非命令行字符串。
9、某系统使用信号量实现有界缓冲区,缓冲区大小为  。初始时,empty=
 ,full=
 ,mutex=
 。当
 个生产者各生成
 个产品后,信号量的值为()
A. empty=0, full=10, mutex=1
B. empty=5, full=5, mutex=1
C. empty=10, full=0, mutex=1
D. empty=5, full=5, mutex=0
答案 :B
难度 :简单
考点 :操作系统
解释 :生产者放一个产品的标准动作是
P(empty); P(mutex); 放入; V(mutex); V(full)。每完成一次,空位少一个所以 empty 减  ,产品多一个所以
full 加  ;而
mutex 是互斥锁,P 和 V 在同一次操作里成对出现,进临界区时减到  、出来时又加回
 ,
 次操作全部完成后必然回到初值
 。故
 个产品后 empty
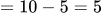 、full
 、mutex
 ,选 B。A 是误按缓冲区被放满
 个算的;C 是漏掉了生产动作对 empty/full 的影响;D 错在把 mutex 停在
 ——那意味着有生产者还卡在临界区里没出来,与”各生成
 个产品后”这个已完成的前提矛盾。
10、在 Java 八种基本类型中,字节数最多且表示范围最大的类型是()
A. double
B. long
C. float
D. int
答案 :A
难度 :简单
考点 :Java 基础
解释 :题干是”字节数最多”与”表示范围最大”两个条件同时成立。按字节数,
int 和 float 各占  字节,
long 和 double 各占  字节并列最多,先淘汰 C、D。在同为
 字节的
long 与 double 之间比表示范围:long 是定点整数,  位全部用于表示整数值,范围约
 ;
double 用 IEEE 754 双精度,把  位拆成
 位符号、
 位阶码、
 位尾数,靠阶码把范围撑到约
 ,远大于
long。代价是牺牲精度——double 只有约  位有效数字,大整数会丢低位,但题目问的是范围不是精度,故选 A。⚠️ 考生所选为 B,只比了字节数没比范围,与推导结果不符,以 A 为准。
11、SQL 实现分组检索的功能,可以使用()
A. 在 GROUP BY 后使用 HAVING 子句
B. 先使用 HAVING 子句,再使用 WHERE 子句
C. 先使用 WHERE 子句,再使用 HAVING 子句
D. WHERE 子句
答案 :A
难度 :简单
考点 :数据库
解释 :分组检索的核心语法就是
GROUP BY,而对分组结果再做筛选要靠跟在它后面的 HAVING,故选 A。理解本题要抓住 SQL 的执行顺序:FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY。WHERE 在分组之前 执行,过滤的是原始行、且不能使用聚合函数;HAVING 在分组之后 执行,过滤的是分组结果、可以写 COUNT(*) > 3 这类聚合条件。B 把顺序说反了,HAVING 不可能跑在 WHERE 前面。C 描述的”先 WHERE 再 HAVING”虽然符合执行顺序,但它是先筛行再筛组的组合用法,本身并没有点出”分组”是靠什么实现的,不是对”实现分组检索”这一问的正面回答。D 只有 WHERE 完全无法分组。
12、三个进程协作完成任务:进程 A 输入数据,进程 B 处理数据,进程 C 输出结果。使用信号量控制执行顺序,信号量及初值应设置为()
A. S1=0, S2=0
B. S1=1, S2=0
C. S1=0, S2=1
D. S1=1, S2=1
答案 :A
难度 :简单
考点 :操作系统
解释 :这是典型的前趋关系同步,要强制 A  B
 C 的顺序。做法是让 A 执行完对 S1 做
V 操作,B 开头先 P(S1);B 执行完对 S2 做 V,C 开头先 P(S2)。信号量初值代表”一开始就已经攒下的可用信号数”,而 A 还没跑完时 B 一个都不该拿到,所以 S1 初值必须为  ,B 会阻塞在
P(S1) 上直到 A 唤醒它;同理 S2 初值也必须为  。故选 A。任何一个初值取
 (B、C、D)都等于凭空送出一个通行证,会让后继进程在前驱还没做完时就抢先执行,同步直接失效——例如 B 取 S1=1,B 就能在 A 输入数据之前先去处理空数据。
第一题:合影
题目描述
学校组织了一次集体合影活动,有  个同学会站在
 级台阶上拍照,学号从
 到
 。每一级台阶的高度为
 ,为了美观,每一级台阶上都必须有一名同学,令
 表示站在从下往上第
 级台阶上同学的学号。
每个同学都有一个身高值,学号为
 的同学的身高用正整数
 表示。为了防止遮挡,对于所有
 ,必须满足
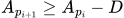 。
现在给定
 个同学的身高序列
 ,请计算有多少种不同排列
 ,使得同学按此方案站到台阶上面后满足上述拍照条件。由于答案可能很大,请输出答案对
 取模的结果。
输入描述
第一行包含两个整数 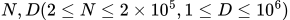 ,分别表示同学的数量和台阶高度。
第二行包含
 个整数
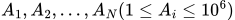 ,表示每个同学的身高。
所有输入均为整数。
输出描述
输出一个整数,表示满足条件的排列方案数对  取模的结果。
样例1
输入
4 1
1 2 4 4
输出
4
样例解释 满足条件的排列方式有:
-
- 从下往上每级台阶上的同学学号分别为
 ,身高为
 。
- 从下往上每级台阶上的同学学号分别为
-
- 从下往上每级台阶上的同学学号分别为
 ,身高为
 。
- 从下往上每级台阶上的同学学号分别为
-
- 从下往上每级台阶上的同学学号分别为
 ,身高为
 。
- 从下往上每级台阶上的同学学号分别为
-
- 从下往上每级台阶上的同学学号分别为
 ,身高为
 。
- 从下往上每级台阶上的同学学号分别为
题解:排序 + 双指针计数
题目问题拆解
 个同学站成一列,要求这一列的身高从前往后每一步下降不超过
 (上升多少不限),问有多少种站法。
这是一道靠换枚举顺序把排列计数拆成连乘的计数题:难点不在算式,而在找到一种插入顺序,让每一步的合法位置数只与已经站好的人有关。
算法实现
直接枚举排列是  种,
 到
 时完全不可行,必须改成”一个一个往队伍里插,每步的选择数连乘”。
插入顺序是分水岭。从矮到高插入时新来的人最高,前驱后继两侧都得检查;从高到矮插入,轮到
 时在场的
 全都满足
 ,于是后继约束
 对每个在场元素都自动成立,把
 插进去只可能破坏它与前驱那一侧。
每步于是只剩一条要验:
 插在
 后面需要
 ,即
 ;插到队首时没有前驱,恒合法。降序排序后,第
 (从
 起)个元素的合法位置数为
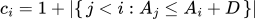 答案即
 ,边乘边对
 取模。样例降序为
 ,四步各有
 个位置,其中
 被两个
 挡住只能打头。
连乘不重不漏靠一组双射:把合法排列里的人按身高从大到小读出,每人被读到时在剩余序列里的位置唯一确定了那一步的选择;反过来任一串选择也只还原出一个排列。身高相同的同学学号不同,按降序排好的下标区分,不会被并成一种。
数
 不必每次重扫。降序下
 ,不合法的
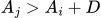 恰好是一段前缀,且
 越往后越矮,这段前缀只增不减,指针单调右移,全程
 。
时空复杂度分析
时间复杂度 :  。瓶颈在排序,双指针的每个下标至多被越过一次、只有
 ;而合法位置数要靠有序性才能用指针数出来,排序省不掉。
 时约
 次比较。
空间复杂度 :
 ,存身高数组。
Java
// 合影 - 排序 + 双指针计数
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.StreamTokenizer;
import java.util.Arrays;

public class Main {
    static final long MOD = 998244353L;

    // 统计满足相邻约束的排列数:把身高从大到小逐个插入序列,累乘每一步的可放位置数
    static long countPlans(int n, int d, int[] a) {
        // 从大到小插入:轮到 x 时已放入的同学都不比 x 矮,
        // 于是"x 的后继 >= x - D"必然成立,只剩"x 的前驱 y 满足 y <= x + D"这一条要管
        Arrays.sort(a);

        long ans = 1;
        int j = n - 1;  // 数组是升序,从尾部往前扫等价于降序;a(j, n-1] 是高得放不下当前身高的那一段
        for (int i = n - 1; i >= 0; i--) {
            long limit = (long) a[i] + d;
            // 把前驱过高(y > x + D)的位置全部剔除,剩下 j - i 个合法插入点
            while (j > i && a[j] > limit) {
                j--;
            }
            // 再加 1 是"放到整个队伍最前面"——没有前驱,恒合法
            ans = ans * (j - i + 1) % MOD;
        }
        return ans;
    }

    public static void main(String[] args) throws Exception {
        // 用 StreamTokenizer 按空白切词读入,N 到 2e5 时比逐行切分快得多
        StreamTokenizer in = new StreamTokenizer(new BufferedReader(new InputStreamReader(System.in)));
        in.nextToken();
        int n = (int) in.nval;
        in.nextToken();
        int d = (int) in.nval;

        int[] a = new int[n];
        for (int i = 0; i < n; i++) {
            in.nextToken();
            a[i] = (int) in.nval;
        }

        System.out.println(countPlans(n, d, a));
    }
}
第二题:金条切割
题目描述
工匠手里有一根由  节小金块连接而成的长条金块。这些小金块从左到右依次排列,第
 节小金块的价值为
 。
为了将金块分发给四位徒弟,工匠需要在金块连接处切三刀,将其分割成四段非空的连续部分,一段金块的价值为其包含的所有小金块价值之和。
工匠希望分配尽可能公平,要求这四段金块价值中的最大值与最小值的差值尽可能小。请你帮助工匠计算出这个最小的差值是多少。
输入描述
输入包含两行。
第一行一个整数 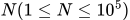 ,表示小金块的节数。
第二行
 个整数
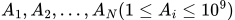 ,用空格分隔,分别表示每一节小金块的价值。
输出描述
输出一行一个整数,表示四段金块价值中最大值与最小值间可能的最小差值。
样例1
输入
5
3 2 4 1 2
输出
2
样例解释
可以将金块分割为 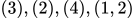 这四段。此时四段的总价值分别为
 。这四个数中的最大值是
 ,最小值是
 ,差值为
 。没有比
 更小的差值。
题解:前缀和 + 枚举中间切点 + 双指针
题目问题拆解
把长度为  的数组切三刀分成四段非空的连续区间,要让这四段和的极差最小。
这是一道靠固定一刀把问题劈成两个独立子问题的题:难点在于看出中间那一刀定下来之后,左右两半的切法互不影响,从而不必三重枚举。
算法实现
三刀的位置组合有  种,
 到
 时枚举不动。先记前缀和
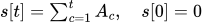 一段
 的价值即
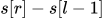 ,任何一种切法都能
 算出四段。
突破口是先固定中间那一刀
 ,把金条劈成
 与
 两半。左半两段之和恒为
 、右半恒为
 ,都是与另一半无关的定值,所以左右各自取最平衡即可,不必联动。
再看单独一半怎么切最平衡。左半两段是
 与
 ,两者之和固定,这意味着”压低最大值”和”抬高最小值”是同一个动作,即让
 尽量贴近
 。于是左刀取第一个满足
 的位置,右刀同理取第一个满足
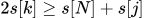 的位置。
这里有个必须留的后手:最贴近目标值的位置可能落在目标值两侧,指针停下的那一格与它左边一格谁更平衡取决于跨过去多少,两个都要试,左右组合共
 种各算一次极差。只取跨过目标值的那一格会漏解,例如左半为
 时指针会停在
 那侧,而切在它左边才是唯一的切法。
指针能单调右移是因为
 ,
 严格递增,两个目标值
 与
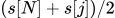 都随
 单增,故
 与
 只进不退。
时空复杂度分析
时间复杂度 :  。前缀和一趟
 ;枚举中间刀
 ,两个指针在整个枚举过程中各只前进至多
 步、均摊
 ,每个
 固定后只试
 种组合。若改用二分找平衡点则是
 ,单调性让这个
 省掉了,瓶颈只剩读入。
空间复杂度 :
 ,存前缀和数组。
Java
// 金条切割 - 前缀和 + 枚举中间切点 + 双指针
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.StreamTokenizer;

public class Main {
    // 求四段价值中最大值与最小值的最小差值
    static long solve(int n, long[] a) {
        // 不足 4 节切不出四段非空,题面约束下不会出现,兜一层防越界
        if (n < 4) {
            return 0;
        }

        // s[i] 是前 i 节小金块的价值和;A_i >= 1 保证 s 严格递增,后面才能用单调指针
        // n 到 1e5、A_i 到 1e9,总和可达 1e14,必须用 long
        long[] s = new long[n + 1];
        for (int i = 0; i < n; i++) {
            s[i + 1] = s[i] + a[i];
        }

        // best 用 -1 当哨兵,表示还没取到过任何一种切法
        long best = -1;
        // i 追踪左半的平衡点,k 追踪右半的平衡点;两个目标值都随 j 单增,所以指针只往右走
        int i = 1;
        int k = 1;
        // 枚举中间那一刀 j:左半 [1..j] 里再切一刀,右半 [j+1..n] 里再切一刀
        for (int j = 2; j <= n - 2; j++) {
            // 左半两段是 s[i] 与 s[j]-s[i],两者之和恒为 s[j],所以"压低最大值"和"抬高最小值"
            // 是同一个选择,把 i 推到第一个满足 2*s[i] >= s[j] 的位置即最平衡
            while (i < j && 2 * s[i] < s[j]) {
                i++;
            }
            // 右半两段之和恒为 s[n]-s[j],同理推到第一个满足 2*s[k] >= s[n]+s[j] 的位置
            while (k < n && 2 * s[k] < s[n] + s[j]) {
                k++;
            }

            // 平衡点跨过目标值,它和它左边一格都要试:谁更平衡取决于跨过去多少
            for (int li = i - 1; li <= i; li++) {
                if (li < 1 || li > j - 1) {
                    continue;
                }
                long p1 = s[li];
                long p2 = s[j] - s[li];
                for (int ri = k - 1; ri <= k; ri++) {
                    if (ri < j + 1 || ri > n - 1) {
                        continue;
                    }
                    long p3 = s[ri] - s[j];
                    long p4 = s[n] - s[ri];
                    long hi = Math.max(Math.max(p1, p2), Math.max(p3, p4));
                    long lo = Math.min(Math.min(p1, p2), Math.min(p3, p4));
                    if (best < 0 || hi - lo < best) {
                        best = hi - lo;
                    }
                }
            }
        }
        return best;
    }

    public static void main(String[] args) throws Exception {
        // N 到 1e5,用 StreamTokenizer 按空白切词读入,比逐行分割快
        StreamTokenizer in = new StreamTokenizer(new BufferedReader(new InputStreamReader(System.in)));
        in.nextToken();
        int n = (int) in.nval;
        long[] a = new long[n];
        for (int i = 0; i < n; i++) {
            in.nextToken();
            a[i] = (long) in.nval;
        }
        System.out.println(solve(n, a));
    }
}